Đào tạo “Bình dân học vụ AI”: Con dao hai lưỡi thời kinh tế số, kinh tế dữ liệu
Trong làn sóng phổ cập công nghệ toàn dân, phong trào “bình dân học vụ AI” đang phát triển như một trụ cột để nâng cao năng lực số quốc gia. Việc đưa người dân tiếp cận, dùng thử và ứng dụng các công cụ trí tuệ nhân tạo (AI) tạo sinh mang lại cơ hội thu hẹp khoảng cách công nghệ nhanh chóng. Tuy nhiên, dưới góc nhìn phân tích chuyên sâu về kinh tế dữ liệu, đồng thời từng tham gia tư vấn cho nhiều chương trình đào tạo tương tự, đây lại là một con dao hai lưỡi: ranh giới giữa một “người dùng thử nghiệm” hào hứng và một “vật thí nghiệm” bị khai thác dữ liệu vô điều kiện chưa bao giờ mong manh đến thế.
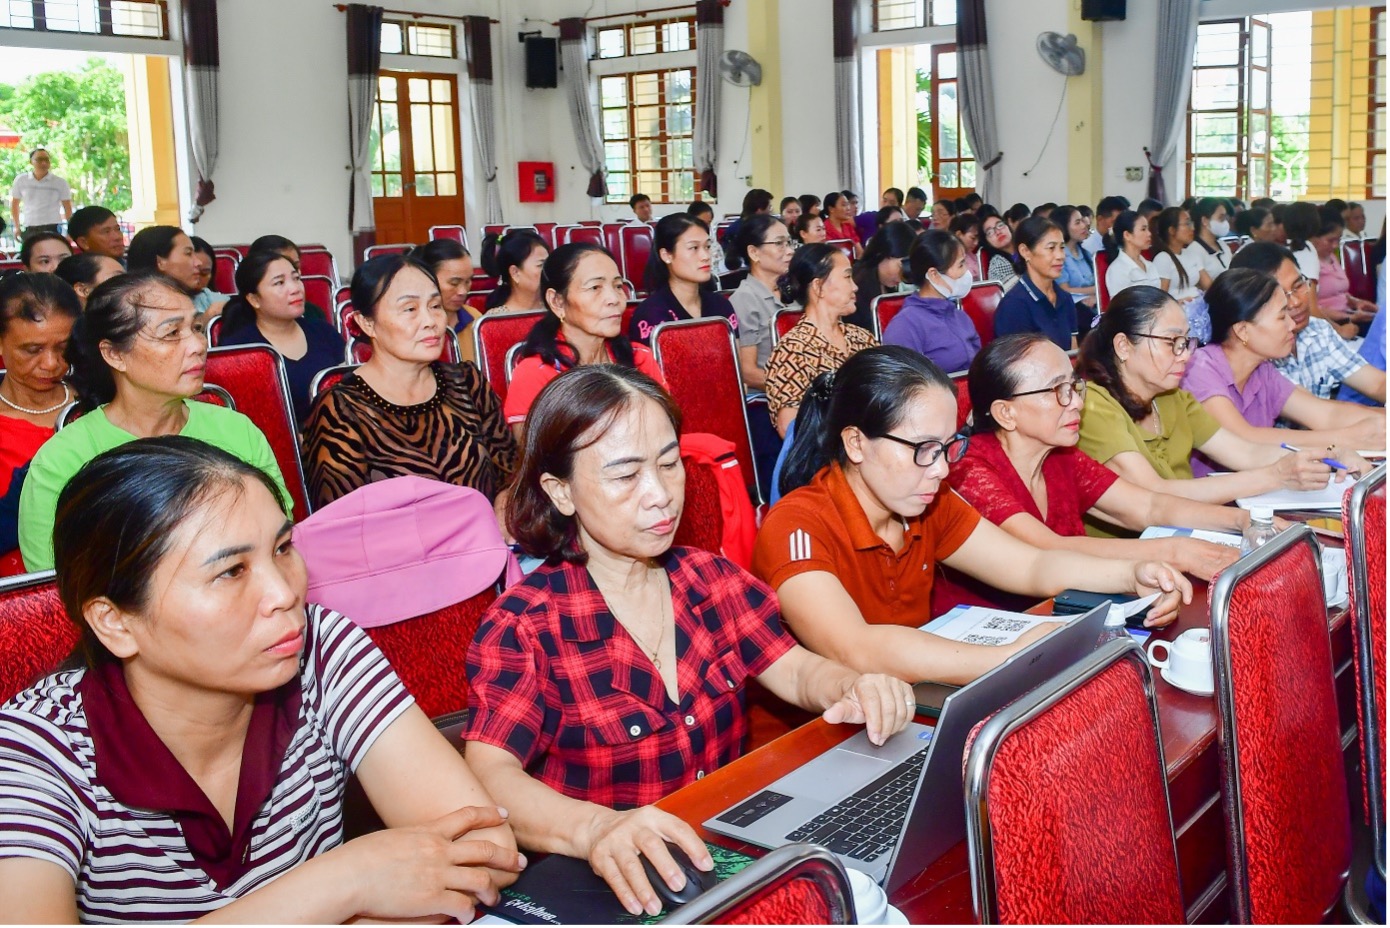
Trong làn sóng phổ cập công nghệ toàn dân, phong trào “bình dân học vụ AI” đang phát triển như một trụ cột để nâng cao năng lực số quốc gia. Ảnh minh hoạ
Cơ hội bình dân hóa công nghệ
Không thể phủ nhận, chiến lược phổ cập AI theo mô hình “bình dân học vụ” đem lại giá trị đột phá cho kinh tế số: bình dân hóa những công cụ tưởng chừng chỉ dành cho chuyên gia, tăng năng suất lao động và xây dựng lực lượng công dân số. Từ tiểu thương đến cán bộ cơ sở giờ đây đều có thể dùng AI để soạn văn bản, tóm tắt tài liệu, sáng tạo nội dung truyền thông hay tối ưu công việc hằng ngày. Rào cản kỹ thuật được rút ngắn, giúp đại đa số lực lượng lao động tiếp cận trợ lý ảo, tạo bước nhảy vọt về năng suất ở cả khu vực công lẫn khu vực tư. Qua đó, tâm lý “sợ công nghệ” dần được xóa bỏ, từng bước nâng mặt bằng kỹ năng số - nền tảng của kinh tế dữ liệu.
Vòng lặp khai thác dữ liệu phía sau các lớp học miễn phí
Mặt sau của tấm huy chương “phổ cập” chính là nguy cơ biến người dùng thành nguyên liệu miễn phí cho các cỗ máy AI. Trong nền kinh tế dữ liệu, câu nói kinh điển “Nếu bạn không trả tiền cho sản phẩm, chính bạn là sản phẩm” được nâng lên một tầm cao mới: bạn không chỉ là sản phẩm, bạn là dữ liệu huấn luyện (training data) và nhân công kiểm thử miễn phí.
Vòng lặp khai thác diễn ra rất tự nhiên: người dùng hào hứng “dùng thử” dịch vụ AI miễn phí hoặc giá rẻ, nhập dữ liệu cá nhân, văn bản nội bộ, hình ảnh nhạy cảm vào khung chat (prompt); doanh nghiệp AI thu thập, tinh chỉnh (fine-tune) và huấn luyện mô hình từ chính dữ liệu đó; kết quả là người dùng vô tình để lộ bí mật kinh doanh, thông tin cá nhân - trong khi doanh nghiệp AI có thể thương mại hóa ngược lại chính dữ liệu ấy.
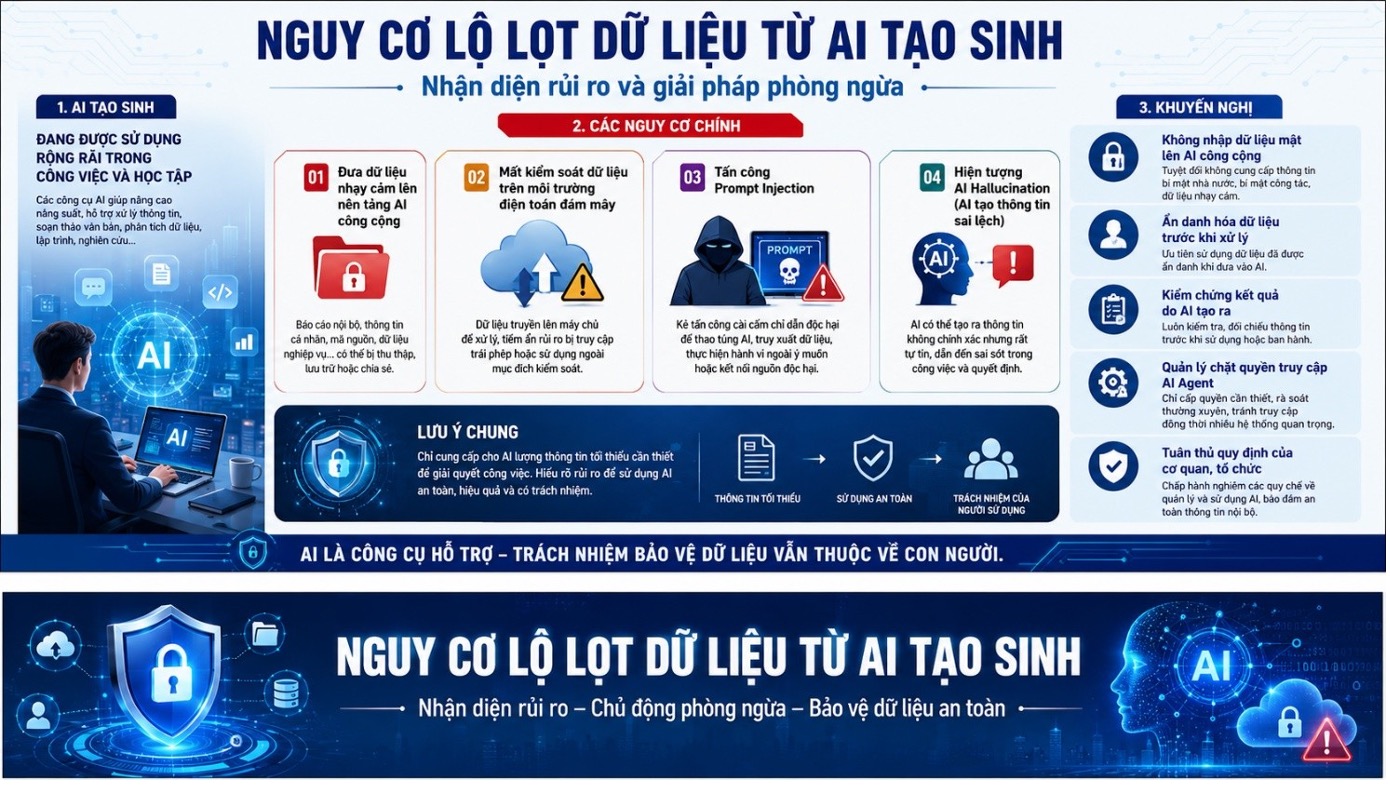
Ảnh minh hoạ.
Rủi ro này tập trung nhiều nhất ở nhóm người mới bắt đầu - học sinh, người cao tuổi, tiểu thương, cán bộ hành chính cơ sở - vốn thiếu kiến thức về an toàn thông tin số nên có thói quen đưa mọi loại dữ liệu vào khung chat. Trên thực tế:
• Cán bộ, nhân viên tải cả dự thảo văn bản, hồ sơ quản lý, tài liệu họp chưa công bố lên AI để nhờ “tóm tắt” hay “sửa văn phong”;
• Doanh nghiệp nhỏ và tiểu thương đưa dữ liệu kế toán, danh sách khách hàng, chiến lược kinh doanh lên các công cụ AI mở để nhờ “phân tích”;
• Người dân cá nhân cung cấp ảnh chụp căn cước, giọng nói, dữ liệu sinh trắc học hoặc thông tin tài chính để nhờ AI “chỉnh ảnh”, “tạo video” hay “tư vấn”.
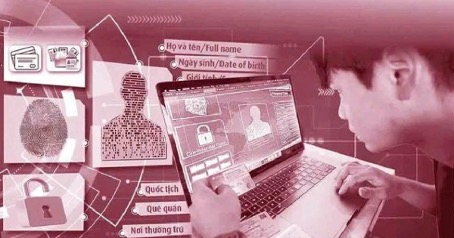
Các tập đoàn công nghệ cung cấp AI miễn phí không đơn thuần làm từ thiện: mỗi câu lệnh, mỗi phản hồi, mỗi thao tác “like/dislike” hay chỉnh sửa của người dùng đều góp phần vào quá trình tối ưu hóa phản hồi từ con người (RLHF - Reinforcement Learning from Human Feedback). Người dân, vì vậy, vô tình trở thành nhân công kiểm thử không lương, giúp mô hình AI nhận diện tiếng Việt địa phương, hiểu ngữ cảnh văn hóa và tự sửa lỗi hệ thống. Nguy hiểm hơn, toàn bộ dữ liệu đầu vào thường được lưu lại để tiếp tục huấn luyện các thế hệ AI kế tiếp mà người dùng không hề hay biết, hoặc đã lỡ bấm “Đồng ý” với những điều khoản dịch vụ dài dằng dặc ít ai đọc hết. Từ đó, tri thức địa phương, bí mật kinh doanh, thậm chí dữ liệu quản lý hành chính có thể “chảy” về máy chủ của các tập đoàn công nghệ xuyên biên giới; còn việc vô tư tải ảnh chân dung, mẫu giọng nói lên các ứng dụng AI giải trí miễn phí lại vô tình cung cấp nguyên liệu hoàn hảo cho kẻ xấu dựng kịch bản lừa đảo deepfake nhắm vào chính người dùng và gia đình họ.
Giáo trình dạy “thao tác”, bỏ quên ranh giới dữ liệu
Điều này đang diễn ra ngay trong quá trình triển khai mạnh mẽ “bình dân học vụ số”, bởi phần lớn chương trình đào tạo, giáo trình hiện nay nghiêng hẳn về “thao tác” - dạy cách gõ prompt sao cho ra kết quả đẹp, cách tạo ảnh, tạo video - mà bỏ qua nội dung quan trọng nhất: ranh giới dữ liệu nào được phép và không được phép nhập vào AI.
Hành lang pháp lý đã bắt đầu được thiết lập: Luật Bảo vệ dữ liệu cá nhân có hiệu lực từ 1/1/2026, và mới đây nhất, Luật Trí tuệ nhân tạo - đạo luật đầu tiên của Việt Nam điều chỉnh toàn diện về AI - có hiệu lực từ 1/3/2026, trong đó nghiêm cấm rõ hành vi “lợi dụng hoạt động nghiên cứu, thử nghiệm, đánh giá hoặc kiểm định hệ thống trí tuệ nhân tạo để thực hiện hành vi trái quy định của luật”. Đây chính là bằng chứng cho thấy ngay cả nhà làm luật cũng nhận thấy ranh giới giữa “cho dùng thử” và “biến thành vật thí nghiệm” mong manh đến mức phải luật hóa riêng.
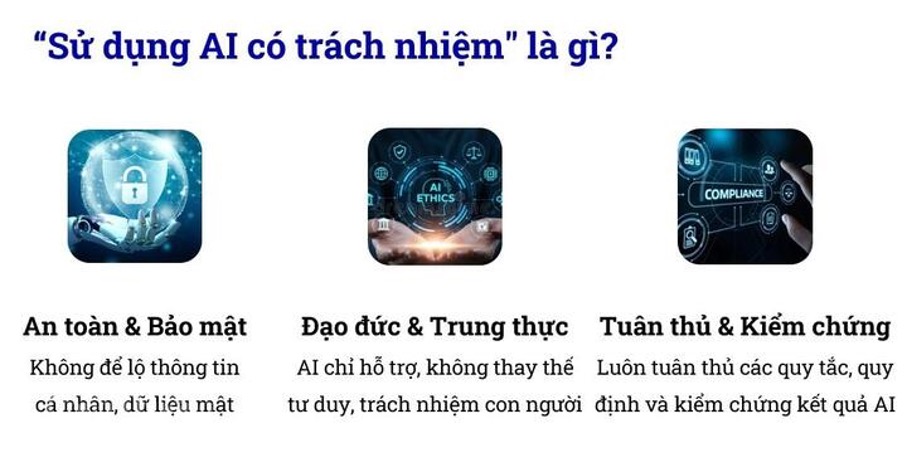
Dù vậy, việc giám sát các luồng dữ liệu do chính người dùng chủ động nộp cho AI xuyên biên giới vẫn là bài toán cực kỳ phức tạp. Đầu năm 2026, hai nền tảng quen thuộc với hàng chục triệu người Việt là Zalo và TikTok đã bị xử phạt tổng cộng 1,69 tỷ đồng vì xử lý dữ liệu vượt phạm vi đồng ý và thu thập dữ liệu trẻ em không có sự đồng ý của phụ huynh - cho thấy đây không phải nguy cơ lý thuyết, mà đang hiện diện ngay trong những ứng dụng người Việt dùng mỗi ngày. Khi ngay cả các nền tảng lớn, bị giám sát chặt, còn chưa tuân thủ đúng, thì không thể kỳ vọng người dùng phổ thông - vốn có khoảng cách nhận thức số còn lớn - tự phân biệt được đâu là phiên bản AI cá nhân có cam kết bảo mật và đâu là bản AI đại trà dùng chính dữ liệu của họ để huấn luyện.
Một số giải pháp
Để phong trào phổ cập AI thực sự mang lại sức mạnh kinh tế số, chứ không biến quốc gia thành “vùng công nghiệp khai thác dữ liệu” của các tập đoàn công nghệ, cần triển khai ngay các giải pháp căn cơ:
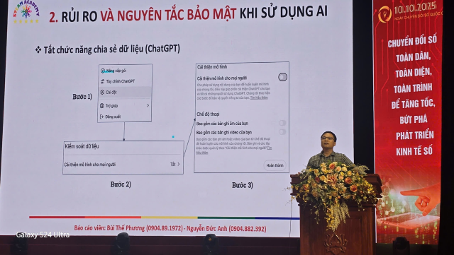
– Tái cấu trúc giáo trình phổ cập AI: đưa nội dung “Bảo mật dữ liệu và an toàn AI” thành môn học bắt buộc ngay từ buổi đầu tiên; dạy người dân cách opt-out (tắt chia sẻ dữ liệu huấn luyện) trên các ứng dụng AI.
– Quy tắc “Dữ liệu đỏ” (Red-line Data): lập bảng chỉ dẫn ngắn gọn, dễ nhớ cho người dân và cán bộ về việc nói “Không” với AI mở.
– Phát triển AI chủ quyền (Sovereign AI): Nhà nước và các tập đoàn công nghệ trong nước cần hạ tầng AI nội địa, lưu trữ dữ liệu tại Việt Nam để phục vụ khu vực hành chính công và doanh nghiệp vừa và nhỏ, đảm bảo dữ liệu không chảy ra nước ngoài.
– Siết chặt khâu kiểm duyệt ứng dụng: cảnh báo và xử lý nghiêm các ứng dụng AI trôi nổi trên mạng xã hội có dấu hiệu “bẫy” thu thập khuôn mặt, giọng nói của người dân.
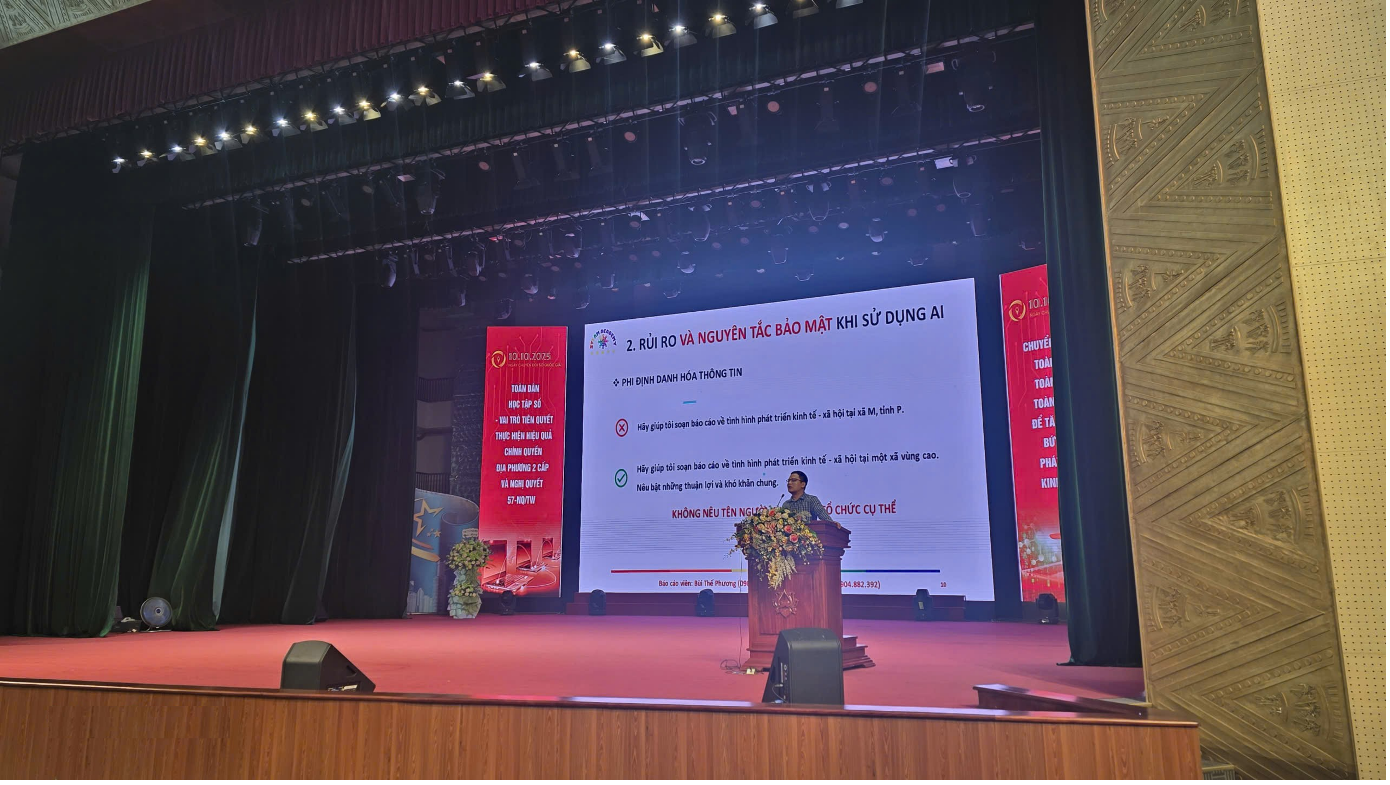
Không thể phủ nhận giá trị của việc phổ cập AI: trong nền kinh tế số và kinh tế dữ liệu, biết dùng AI đang trở thành một năng lực sinh tồn, không khác gì biết đọc biết viết một thế kỷ trước - đúng như tinh thần ban đầu của “bình dân học vụ”. Nhưng một phong trào phổ cập quy mô toàn dân, nếu chỉ dạy thao tác mà bỏ qua quyền dữ liệu, sẽ vô tình biến chính người học thành nguồn nguyên liệu miễn phí, dồi dào và ít phòng vệ nhất cho các mô hình AI đang cần dữ liệu để huấn luyện. AI là động lực không thể đảo ngược của nền kinh tế số, và phổ cập AI cho toàn dân là bước đi chiến lược, đúng đắn. Nhưng một chiến dịch “Bình dân học vụ AI” nhân văn và bền vững phải là chiến dịch trao cho người dân năng lực làm chủ công nghệ, chứ không phải biến người dân thành tài nguyên bị khai thác.
“Giúp người dân hiểu được giá trị của dữ liệu cá nhân trước khi dạy họ gõ câu lệnh AI - đó mới là cốt lõi của một lực lượng công dân số trưởng thành.”
Th.S Nguyễn Đức Anh
 Đào tạo “Bình dân học vụ AI”: Con dao hai lưỡi thời kinh tế số, kinh tế dữ liệu
 GS. TS. Thái Thị Thanh Mai: Đổi mới sáng tạo bắt đầu từ việc dám đặt câu hỏi, dám thử nghiệm và dám chấp nhận điều chỉnh

 Nghị quyết 57-NQ/TW của Bộ Chính trị có 3 ý nghĩa lớn đối với lĩnh vực tự động hóa