Người dùng AI bằng ngôn ngữ khác tiếng Anh có thể phải trả nhiều chi phí hơn
Các mô hình trí tuệ nhân tạo (AI) cần lượng token khác nhau để xử lý cùng một nội dung tùy theo ngôn ngữ. Chênh lệch này có thể làm tăng chi phí, kéo dài thời gian phản hồi và hạn chế khả năng tiếp cận AI của người dùng…
- 4 sàn thương mại điện tử lớn thu về 442 nghìn tỷ đồng trong 9 tháng
- Quy định mới về cấp tài khoản hạn ngạch phát thải khí nhà kính và tín chỉ carbon
- Phát huy vai trò khoa học, công nghệ nâng cao năng lực ứng phó với các đe dọa an ninh phi truyền thống
- Phát triển AI lấy con người làm trung tâm, thúc đẩy hợp tác quốc tế
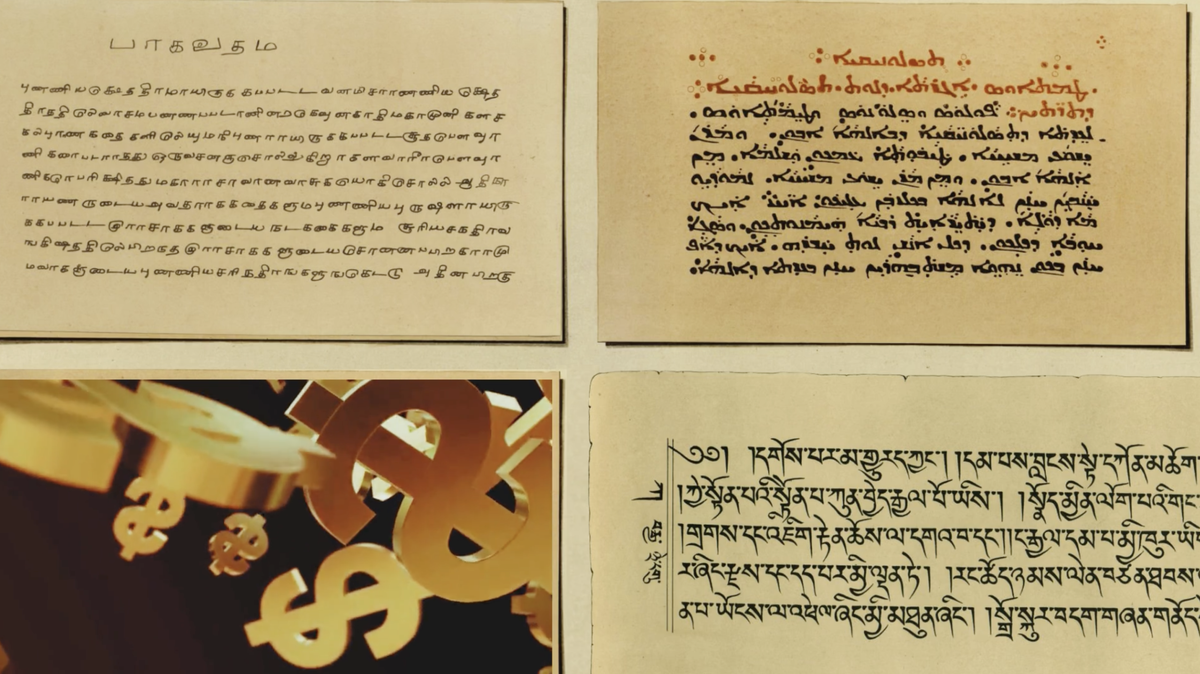
Với một mô hình AI được nghiên cứu, chênh lệch chi phí token giữa các ngôn ngữ tăng lên tới 17 lần. Ảnh: iStock
Theo nghiên cứu do Liên minh vì công bằng ngôn ngữ trong nghiên cứu AI (Coalition for Language Equity in AI Research) công bố tháng trước, các mô hình AI có thể sử dụng lượng token chênh lệch đáng kể giữa các ngôn ngữ. Nhóm nghiên cứu gọi đây là “thuế tokenizer” (tokenizer tax), một khoản chi phí tiềm ẩn đối với những ngôn ngữ có ít dữ liệu trên môi trường số.
“THUẾ TOKENIZER” TẠO RA CHÊNH LỆCH CHI PHÍ GIỮA CÁC NGÔN NGỮ
Token là đơn vị dữ liệu mà mô hình AI xử lý, có thể tương ứng với một từ, một phần của từ hoặc một chuỗi ký tự. Tokenizer là công cụ phân tách văn bản thành những đơn vị này. Số lượng token ảnh hưởng trực tiếp đến chi phí sử dụng nhiều dịch vụ AI, vốn được tính dựa trên lượng dữ liệu đầu vào và đầu ra.
Nghiên cứu cho thấy ngay trong nhóm 20 ngôn ngữ phổ biến nhất trên Internet, những ngôn ngữ có mức sử dụng token cao nhất cần lượng token gấp 1,5 đến 5 lần so với các ngôn ngữ có mức sử dụng thấp nhất.
Khi mở rộng phạm vi khảo sát lên 200 ngôn ngữ, khoảng cách còn lớn hơn. Với một mô hình AI được nghiên cứu, chênh lệch chi phí token giữa các ngôn ngữ tăng lên tới 17 lần.
Theo nhóm nghiên cứu, một công ty khởi nghiệp tại Bengaluru, Ấn Độ, có thể phải trả thêm chi phí cho mỗi yêu cầu và câu trả lời của AI so với đối thủ tại Austin, Mỹ, chỉ vì sự khác biệt về ngôn ngữ sử dụng.
Bất bình đẳng này không chỉ ảnh hưởng đến chi phí. Lượng token lớn hơn còn có thể khiến thời gian phản hồi kéo dài và làm giảm dung lượng ngữ cảnh hữu dụng của mô hình. Những hạn chế này đặc biệt bất lợi tại các khu vực có nguồn lực tính toán và hạ tầng kết nối còn hạn chế.
THIẾU DỮ LIỆU VÀ KHÁC BIỆT HỆ CHỮ VIẾT LÀM GIA TĂNG BẤT LỢI
Số lượng token lớn hơn còn ảnh hưởng đến khả năng lưu giữ lịch sử hội thoại và tài liệu trong quá trình sử dụng AI, từ đó tác động đến chất lượng dịch vụ.
Người sử dụng những ngôn ngữ ít phổ biến trên Internet có thể phải trả chi phí cao hơn khi dùng trí tuệ nhân tạo (AI) so với người dùng tiếng Anh hoặc các ngôn ngữ phổ biến khác. Nguyên nhân nằm ở số lượng token mà mô hình cần để xử lý nội dung.
Pratyush Choudhury, đồng sáng lập Activate AI, quỹ đầu tư mạo hiểm tại Ấn Độ chuyên về AI, cho biết vấn đề này có thể ảnh hưởng trực tiếp đến những ứng dụng đòi hỏi khả năng ghi nhớ thông tin lâu dài.
Ông lấy ví dụ về một ứng dụng gia sư AI. Để hỗ trợ học sinh hiệu quả, hệ thống cần ghi nhớ những lỗi người học từng mắc phải và các giải thích đã đưa ra. Nếu lịch sử trao đổi bằng một ngôn ngữ tiêu tốn dung lượng ngữ cảnh nhanh hơn, hệ thống sẽ có ít không gian hơn để duy trì những thông tin cần thiết.
Theo Choudhury, bất lợi về ngôn ngữ vì thế có thể ảnh hưởng đến cả chất lượng dịch vụ, chứ không chỉ chi phí sử dụng.
Một hướng khắc phục là cải thiện nguồn dữ liệu huấn luyện, đặc biệt với những ngôn ngữ và phương ngữ còn ít tài nguyên số.
Raoul Nanavati, đồng sáng lập kiêm Giám đốc điều hành Navana.ai, công ty khởi nghiệp tại Mumbai chuyên về hạ tầng AI giọng nói, dẫn ví dụ về RESPIN, sáng kiến hợp tác với Viện Khoa học Ấn Độ và được Quỹ Gates tài trợ. Dự án đã thu thập văn bản từ người bản ngữ của 38 phương ngữ, cùng dữ liệu giọng nói được đọc thành tiếng.
Tuy nhiên, nghiên cứu cho thấy mức độ phổ biến của ngôn ngữ không phải yếu tố duy nhất quyết định hiệu quả sử dụng token. Hệ chữ viết cũng đóng vai trò quan trọng.
Chẳng hạn, tiếng Asturian có tương đối ít người nói và không có dữ liệu trên Common Crawl, kho dữ liệu web được sử dụng rộng rãi trong nghiên cứu AI. Dù vậy, ngôn ngữ này vẫn có lợi thế nhờ sử dụng chữ Latin và có quan hệ gần gũi với những ngôn ngữ Roman như tiếng Italy.
Ngược lại, tiếng Miến Điện, tiếng Tây Tạng, tiếng Khmer, tiếng Lào cùng một số hệ chữ viết như Tifinagh và Ol Chiki thường gặp bất lợi trong hầu hết mô hình được khảo sát, do những hệ chữ này ít xuất hiện trong dữ liệu huấn luyện tokenizer.
CẦN THIẾT KẾ TOKENIZER PHÙ HỢP VỚI NHIỀU NGÔN NGỮ
Dheemanth Reddy, Giám đốc điều hành Maya Research, doanh nghiệp phát triển các mô hình AI hội thoại hướng tới khoảng 5 tỷ người dùng Internet tiếp theo, cho rằng nhiều tokenizer hiện nay vẫn được tối ưu hóa chủ yếu cho tiếng Anh và những ngôn ngữ có nguồn dữ liệu dồi dào.
Theo ông, thiếu dữ liệu số chất lượng cao là một nguyên nhân quan trọng khiến các ngôn ngữ ít được đại diện gặp bất lợi. Tuy nhiên, cải thiện dữ liệu huấn luyện chưa đủ để giải quyết vấn đề nếu tokenizer vẫn phân tách những ngôn ngữ này kém hiệu quả.
Reddy nhận định giá token đang giảm nhanh, qua đó có thể làm giảm tác động trực tiếp của chênh lệch chi phí theo thời gian. Dữ liệu đa ngôn ngữ tốt hơn, bao gồm dữ liệu tổng hợp, cũng có thể cải thiện chất lượng mô hình.
Dù vậy, thu hẹp khoảng cách về token vẫn đòi hỏi các phòng nghiên cứu AI chủ động thiết kế tokenizer thế hệ mới, có khả năng xử lý hiệu quả hơn những ngôn ngữ và hệ chữ viết đang chịu bất lợi.
Choudhury cho rằng hiệu quả xử lý ngôn ngữ cần trở thành một tiêu chí phát triển sản phẩm, bên cạnh độ chính xác, tốc độ và độ tin cậy. Theo ông, dù bình đẳng tuyệt đối giữa các ngôn ngữ có thể khó đạt được, những chênh lệch lớn và kéo dài vẫn cần được giải thích và có kế hoạch cải thiện.
Ông đề xuất các phòng nghiên cứu AI lớn công bố bảng đánh giá theo từng ngôn ngữ, thể hiện chi phí để hoàn thành thành công những nhiệm vụ tương đương, đồng thời đặt ra mục tiêu cải thiện có thể đo lường đối với những ngôn ngữ được phục vụ kém hiệu quả nhất.
 Nhật Bản: GMO Internet treo thưởng 1 triệu USD truy tìm tin tặc xâm nhập hệ thống máy chủ
 Hàn Quốc tổng kiểm tra hạ tầng công nghệ thông tin sau hàng loạt vụ tấn công mạng